
为什么我越来越看好“Checker”类网站?
用户在输入框里填了一个域名,点"检查",三秒后看到结果。这三秒里发生的事,决定了这个 Checker 站能不能活下去。
多数人对 Checker 类工具的第一印象是"简单"——一个输入框,一个判定结果。但真正难的从来不是页面,是那个判定所依赖的数据从哪来、多久更新一次、数据源断了怎么办。
三类数据源,成本差着一个数量级
第一类不需要外部来源:用户给什么,你就查什么。JSON 格式是否合法、密码强度够不够、某段 CSS 有没有语法错误、证书链是否完整。这类 Checker 整个流程能在浏览器里跑完,服务端只发静态文件,边际成本接近零。
第二类需要主动抓取:某个页面有没有更新、某个站点是否宕机、某条记录有没有变化。这类要定时任务、要存历史快照、要处理抓取失败和重试。
第三类依赖别人的 API:账号是否存在、某条数据有没有登记在册。这一类的成本不由你决定,由 API 提供方决定,而且随时会变。
一个人做 Checker,应该尽量待在第一类,谨慎进入第二类,把第三类当成有保质期的生意来做。
SQLite 存快照,nginx 挡在前面,Docker 定时跑
第二类 Checker 的工程结构其实很成熟,而且轻得超出预期。
抓取任务塞进一个 Docker 容器定时跑,结果写进 SQLite——一个文件就是一个数据库,备份等于复制文件,不需要数据库运维。页面读取时先查本地快照,缓存和静态资源交给 nginx 挡在前面,重复查询基本到不了应用层。
三个组件全是成熟稳定的东西,一个人可以完整理解每一层的行为,这一点比性能重要得多:出问题时你能定位,而不是只能重启。
真正要花心思的是抓取的礼貌性:超时时间、重试间隔、并发上限、标识是否诚实、失败之后要不要降级到上一次的快照。这些写不好,数据源会把你封掉,而你没有申诉渠道。
Data Fetcher 把"评估平台风险"写进筛选顺序,不是谨慎是被逼的
Andy Cloak 的 Data Fetcher 是 Airtable 上拉数据的扩展,MRR 23000 美元、600 个付费客户,他一个人在伦敦运营。
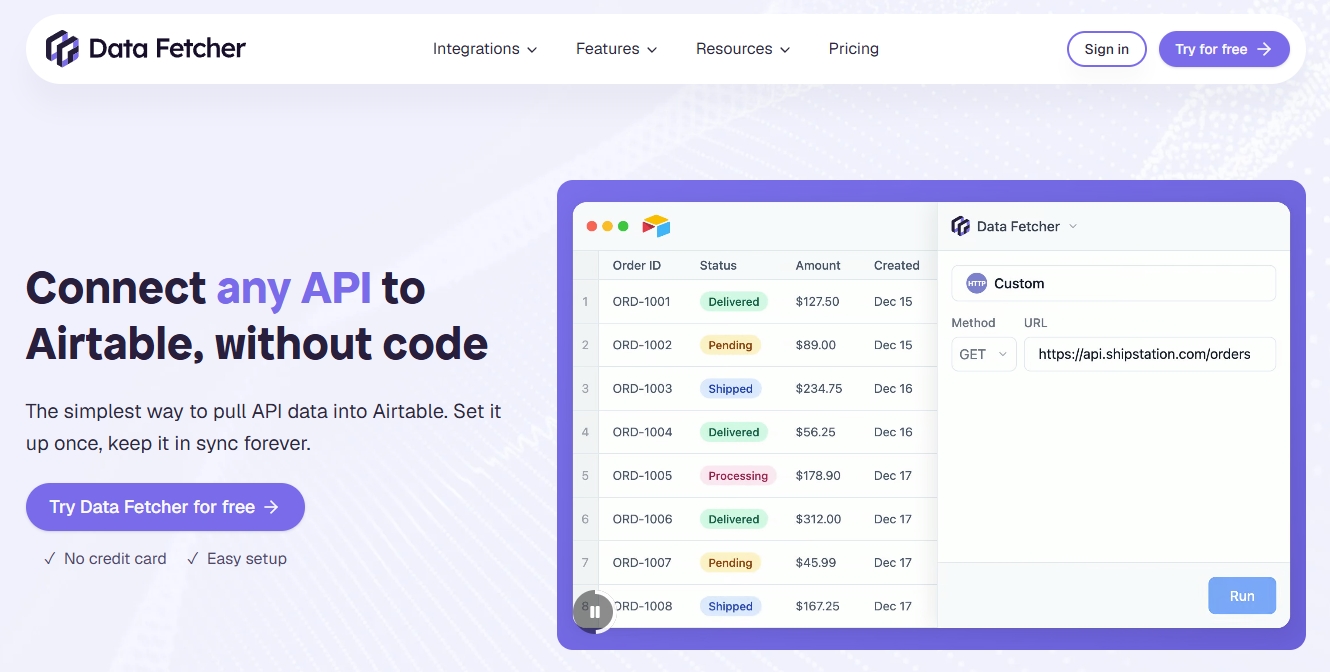
Data Fetcher 首页写明 Connect any API to Airtable, without code,目标用户就是 Airtable 用户。
他公开的选题顺序里有两步很扎眼:“确认有 API"和"评估平台风险”。这不是方法论洁癖。一个寄生在平台上的工具,平台改一次接口、上线一个官方功能、调整一次分成,你的收入模型就得重写。
Checker 类站只要有外部数据源依赖,适用同一条规则。动手之前先问三件事:这个数据源有没有公开接口、它自己有没有动机做同样的功能、它断掉之后我能不能换一家。第二件最容易被忽略,也最致命——数据源自己做一个官方检查页,成本比你低得多。
只写"不通过"三个字的 Checker 没有价值
我看好 Checker 类还有个跟技术无关的理由:它的输出天然带下一步。
Calculator 算完就结束了,Converter 转完就走了,而 Checker 给的是判定——合格还是不合格。人拿到否定判定之后一定会问"那我该怎么办"。
结果页的质量差距因此被放大。只显示"不通过",用户立刻关掉去搜别家;把结果拆成若干具体项,逐条说明哪一项不合格、判定依据是什么、改完之后会变成什么样,用户会照着改,改完再回来验一次。
这个"改完再验一次"是 Checker 类最独特的资产。它把一个单次工具变成了循环:改 → 检查 → 再改。TinyWow 那 47.29% 的直接访问占比也是这么来的,只不过它靠的是"文件处理"这个动作的反复发生,Checker 靠的是"改完想再确认一次"的心理。
判定规则本身要能解释
还有个容易被跳过的设计:判定标准要写在页面上。用户不接受一个来路不明的分数。用的哪个版本的标准、阈值定在哪、为什么这项权重大——写清楚,这既是信任问题,也是你唯一可能被引用、被讨论的地方。
一个不解释规则的 Checker 和一个能解释规则的 Checker,技术实现可能只差几百字文案,但命运完全不同:前者的结果被质疑时无法自辩,后者会被别人当成标准引用。
回到开头那三秒。如果这三秒全部在浏览器里完成,你几乎没有成本;如果这三秒要跨三个外部 API,你承担的是三份不确定性。你会选哪个?
Data Fetcher 数据来自 Andy Cloak 公开分享;TinyWow 流量结构为第三方估算(2026 年上半年)。