
AI能不能自动做网站客服?
我给一个小工具站接过自动客服,上线第一天它就替我答应了一件产品根本做不到的事——告诉用户"你的文件我们会保留 30 天",而那个站的处理逻辑是关掉页面就删。用户很高兴地回了个"好的,那我下个月再来取"。
这类错误和代码 bug 不一样。代码错了会报错,客服说错了只会留下一个以为自己被承诺过的用户。所以自动客服能不能做,答案不在模型能力上,在于它回答时依据的是什么。
客服问题的分布比想象中集中
我把站上过去一年的客服邮件导出来分了一遍类,结果有点意外:八成以上的问题集中在不到十个话题上。
付费类最多:支持哪些支付方式、能不能开发票、订阅怎么取消、换了设备还能不能用。其余集中在功能确认上:某个格式支不支持、文件大小上限是多少、手机上能不能跑。剩下的才是零星的故障报告和合作咨询。
这个分布决定了自动客服的可行性——它要覆盖的其实是一个很小的事实集合,而不是开放域对话。真正难的是这十来个问题的答案必须准确、一致,并且和产品的实际行为完全对齐。
能做的前提是先有一份可检索的事实
我后来重做的顺序是这样的:先把事实整理出来,再接模型。
事实包括三块。产品事实:功能列表、限制参数(文件大小、次数、格式)、价格与退款规则、数据处理方式。政策事实:隐私说明里承诺了什么、服务条款里写了什么。技术事实:常见报错对应的真实原因和解决办法。
这三块整理完,存成一个结构化的表。字段简单就行,用 SQLite 一个文件足够——几百条记录,改动可追踪,查询也快。重要的是每条事实都要有来源:来自产品文档哪一段、来自哪次实际测试。没有来源的条目宁可不写,因为模型会把它当成真的一样说出来。
接的时候约束住一件事:只能基于检索到的事实回答,检索不到就明确说"这个问题我需要人工确认",并引导用户留邮箱。这条规则是最关键的防线,它把幻觉从"编一个答案"降级成"承认不知道"。
它做不好、也不该让它做的部分
有几类必须转人工,无论模型多强。
涉及钱的争议:退款、重复扣款、订阅状态异常。这类问题用户本来就有情绪,答错一次会直接升级成差评。
涉及具体用户数据的:查订单、查账户状态、恢复数据。这需要真的去查系统,模型没有权限也不该有。
涉及承诺的:什么时候上线某个功能、能不能定制、能不能给折扣。这类问题的正确答案是"我不能替你决定",而模型天然倾向于给出肯定的、让人满意的回答。
判断标准很朴素:凡是答错了需要你出面补救的,都不要交给它。 自动客服的价值在于把高频、低风险、答案固定的问题接住,让人工只处理剩下的那部分。它不应该是"代替人工",而是"把人工的问题量降下来"。
前端实现上的几个坑
把客服窗口接进页面时,有几个具体问题值得提前想清楚。
接口要有超时和降级。模型响应可能几秒也可能十几秒,前端必须给出明确的等待反馈,超时之后要能优雅地退回到"留下联系方式"。这一点在 JavaScript 教程 的异步请求部分属于基础内容,但在客服场景里是体验的分水岭——用户盯着一个转圈的窗口十秒钟,比直接看到一个表单要焦躁得多。
上下文要自己管。多轮对话的历史不能直接全量塞进每次请求,一是长度会爆,二是成本会涨。通常做法是服务端保存会话、每次只带最近的几轮加一个摘要。
要记录问答日志,而且要定期看。看什么:哪些问题它答不上来(说明事实库缺条目)、哪些问题的答案被用户继续追问(说明答得不准)。这个反馈循环是让系统变好的唯一途径,跑起来之后每周花半小时扫一遍日志,比调任何参数都有效。
这笔账怎么算
Data Fetcher 是个有意思的对照:MRR 两万三千美元、600 个付费客户,伦敦一个人运营。一个人服务 600 个付费客户能撑住,靠的不是客服机器人有多聪明,而是产品把用户能问的问题收敛到了一个很小的范围——它做的是明确的数据同步,边界清楚,文档完整,用户能自助解决大部分事。
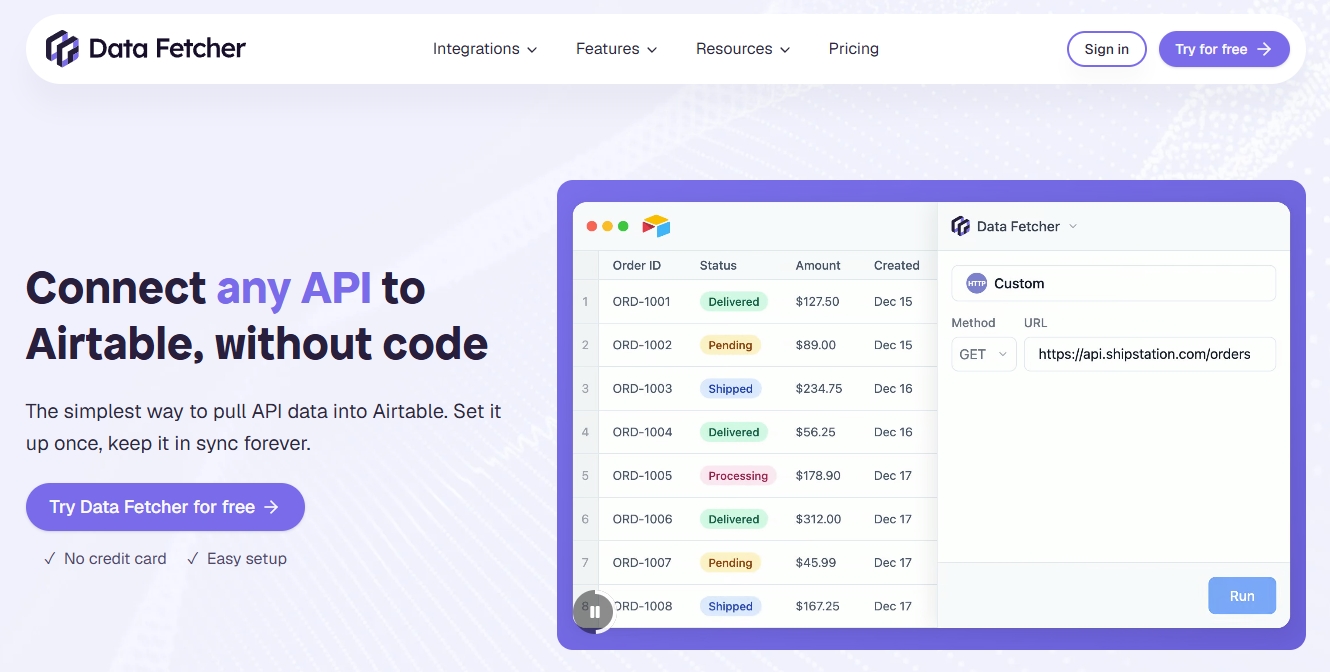
Data Fetcher 首页写明 Connect any API to Airtable, without code,目标用户就是 Airtable 用户。
所以真正省客服成本的不是接了 AI,是把产品设计得不容易产生疑问。一个纯客户端、不用注册、不落数据的工具,用户根本没什么可问的;而一个需要账号、订阅、数据迁移的产品,问题会成倍增长。工具型产品在这一点上有天然优势,这也是 在线工具 这类形态对个人开发者友好的原因之一。
先收敛问题,再上机器人。顺序反过来,你会得到一个 24 小时不停许诺的窗口。
Data Fetcher 数据为其在 Indie Hackers 上的公开披露。