
AI能不能一个人完成产品经理、设计师和程序员的工作?
Cakedesk 是个很好的观察样本。一个开发者用 Electron + React + Node.js 做的桌面应用,一次性授权 €69,2025 年卖了 239 份新授权,毛收入约一万六千欧元。产品、界面、代码全是一个人完成的。
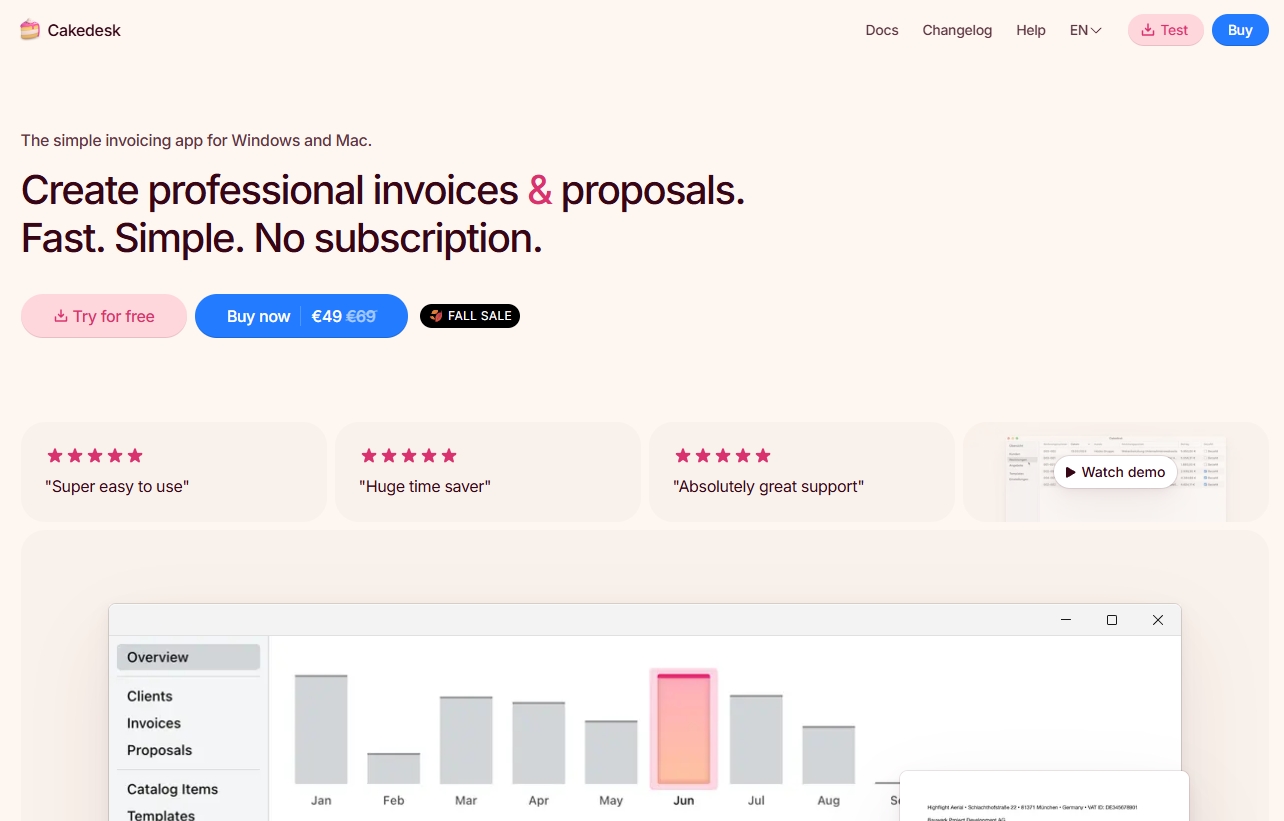
Cakedesk 首页把 Watch demo 放在评价旁边,没装过的用户先看演示再下单。
它证明的是"一个人能做出三个角色的产出物"。但要看清 AI 在这件事上的边界,得先问另一个问题:那三个角色平时真正在做什么。
三个角色共同的部分不是产出物
产品经理产出文档和优先级,设计师产出稿子和规范,程序员产出代码。这是产出物层面的划分,也是 AI 最容易介入的层面——文档、界面、代码,它都能生成,而且生成得越来越像样。
但三个角色真正共享的是另一件事:取舍。
产品经理决定这个版本不做哪个功能;设计师决定为了信息密度牺牲一点留白;程序员决定为了可维护性放弃那个更快的写法。这些东西不出现在产出物里,它们体现为产出物里"没有"的那部分。
AI 生成不了"没有"。你让它设计一个页面,它一定会填满;你让它写一个方案,它一定会写全面;你让它实现功能,它一定会把所有能想到的情况都处理一遍。它的默认倾向是增加,而产品工作的核心动作是削减。
Cakedesk 之所以是一个像样的产品而不是一个功能堆,不是因为它功能少,是因为有人决定了哪些东西不该在里面。这个决定 AI 做不了,因为它没有"这个用户会为什么付费"的信息。
那 AI 到底顶掉了哪部分
比较诚实地说,顶掉的是这三个环节:
从零到第一版的成本几乎归零。以前做一个原型要几天,现在几十分钟。这件事的影响比想象的大——它意味着你可以同时试五个方向,而不是赌一个。
陌生领域的入门门槛被削平了。一个后端开发者要做桌面应用,以前得先学一圈 Electron 的打包、签名、自动更新;现在可以在做的过程中问。Cakedesk 用的这套栈,放在十年前对个人来说是相当大的投入。
重复性产出被自动化了。图标、占位文案、表单校验、错误提示、国际化翻译,这些占了产品工作量一大块但几乎不产生差异化的东西,现在可以忽略不计。
剩下的是:判断哪个方向值得做、判断这个交互是不是别扭、判断这段代码能不能进主干。三项全是判断,没有一项能被生成。
这也是为什么"三个角色一个人做"这件事,难度并不像看上去那么均匀地分布。做产出物那部分被削平了,做判断那部分一点没变。以前三个角色分摊判断压力,现在全压在一个人身上——AI 让产出变快的同时,把决策密度提高了。
合并成一个角色之后,多了什么
一个人同时做三个角色,效率损失不在时间上,在角色切换带来的决策污染上。
当你是产品经理时,你应该想"这个功能有没有人愿意付费";当你切到程序员视角,你很容易变成"这个功能实现起来挺有意思"。两个判断会互相干扰,而一个人做的时候没有人帮你指出这一点。
我的应对方式是把决策顺序固定下来,并且写下来:先写清楚这个功能服务的具体场景和不服务的场景,再画交互,最后才动手写。顺序不能乱,因为一旦先写了代码,沉没成本就会开始影响你对"要不要保留"的判断。
技术栈的选择上,个人的最优解和团队不一样。选你能在凌晨两点独立排查完的栈,比选"业界最佳实践"重要得多。React 加本地数据库这种组合对个人项目很友好——界面部分组件化清晰,数据落在 SQLite 里就是一个文件,备份、迁移、调试都简单,不需要维护任何外部服务。分发和自动更新这类繁琐事交给桌面应用自己的打包生态,别在这里造轮子;如果产品线里还有需要长期跑的服务,再用 Docker 把它固化下来。
一个人能跑到什么规模
Data Fetcher 是个参照:MRR 两万三千美元、600 个付费客户,伦敦一个人运营。这个数字说明一个人能撑起的规模比多数人以为的大,但也说明了一个前提——它的功能边界非常清楚,不做定制,不做集成服务,用户自助完成。
一旦产品开始需要"为某个客户改一版",一个人的模型就到头了。MicroConf 的统计里有个数字挺有意思:37% 的创业者在出售公司时团队规模是 2 到 5 人。也就是说,走到退出那一步的,多数早就不是一个人了。
所以更准确的说法是:AI 让一个人能完成从零到产品上线的全过程,也让一个人能维持一个不小的规模,但它没有改变"规模上来之后需要更多人"这件事。它改变的是起点,不是终点。
三个角色的产出物可以外包给模型,取舍只能自己做——而产品值多少钱,恰恰由取舍决定。
Cakedesk 的技术栈与销售数据来自作者公开自述;Data Fetcher 数据为其在 Indie Hackers 上的公开披露;团队规模数据来自 MicroConf 调研。