
Generator类网站还能不能做?
“Generator 最容易做,所以最值得做”——我以前真是这么想的,现在认为这是把因果搞反了。
容易做意味着供给过剩,供给过剩意味着你做出来的东西没有稀缺性。而且 Generator 类还背着别的类型没有的一个风险:它生产出来的内容是无限的,而无限生产正是搜索引擎最警惕的那件事。
每天 668 次发布、2.8% 上首页,供给过剩有具体数字
Product Hunt 上每天大约有 668 次产品发布,最终能上首页推荐的比例约 2.8%。这不是说发上去没用,而是说"做一个东西然后发出去"这条路径已经拥挤到了需要用概率来描述的程度。
Generator 是这条路径上最挤的品类,因为它开发成本最低。一个随机密码生成器、一个占位图生成器,前端几行代码就能跑起来,一个下午做完一个站。
Generator 的三层实现,越往上越难守住质量
第一层是模板替换:把用户填的几个字段塞进固定模板。实现最简单,产物高度重复。
第二层是带约束的随机:在规则范围内生成,比如密码必须含大小写和符号、配色必须满足对比度。这一层开始需要校验逻辑,产物质量可控。
第三层是模型生成:文本、图片、代码,产物不可预测。这一层你无法保证输出是对的,而用户恰恰会直接拿去用。
前两层可以在浏览器里跑完,用 JavaScript 就够;第三层基本要调外部接口,成本和产出质量都不在你手上。顺带说一句,二维码、验证码、占位图这类需要在客户端做编码或像素级计算的生成器,交给 WebAssembly 会更稳,也更容易控制体积。
同样是模板生成,Calculator 行得通 Generator 不行
这里有个很值得琢磨的对照。Omni Calculator 也是模板生成——把计算器抽象成配置,页面由模板生成,上千个页面骨架高度一致,月访问约 1429 万。
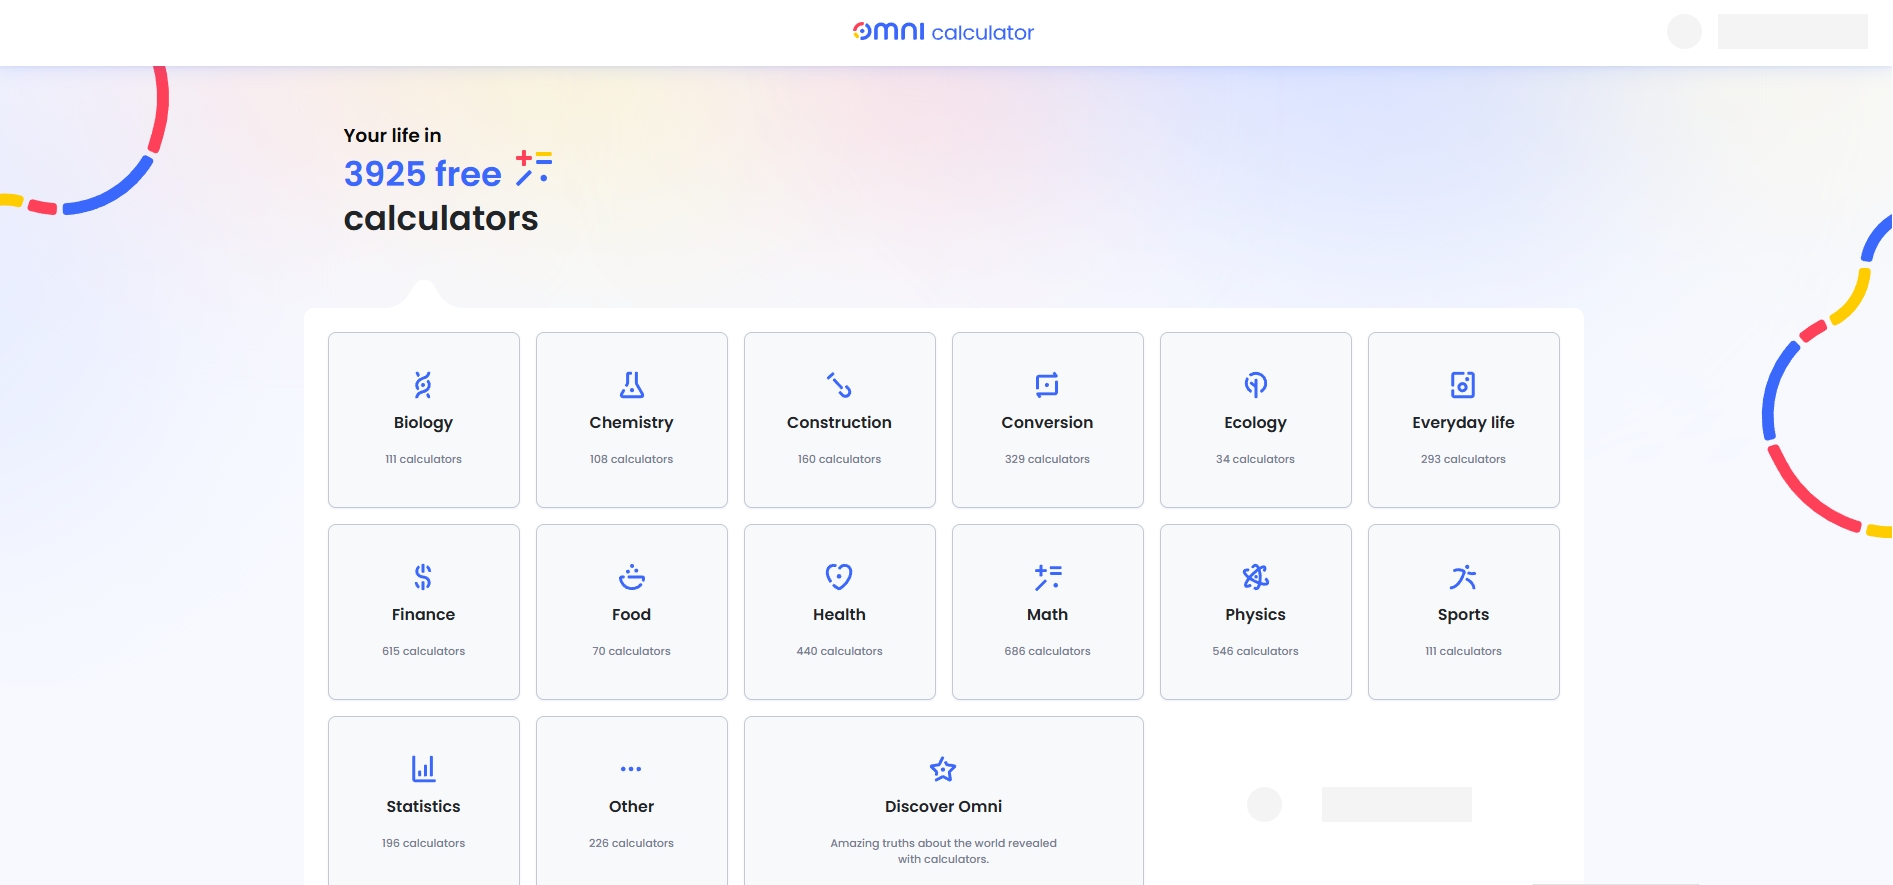
Omni Calculator 首页的 Construction 分类收着 160 个计算器,从材料估算到工程量都有。
为什么同样是规模化生成,它没有被判定成低质量内容?
因为每个计算器输出的是可复算的确定结果。用户输入不同,输出必然不同,而且这个不同是真实的、可被第三方验证的。页面骨架相同,但每个页面回答的是一个真实存在的具体问题。
Generator 的麻烦在于,它的输出往往只是"又一个差不多的东西"。一旦产物之间没有实质差异,规模化就从优势变成了负担。
4.6.6 那条政策写的就是批量生成的内容
Google 的垃圾内容政策里有两条跟 Generator 类站直接相关。
一条是 Scaled Content Abuse(4.6.5),针对为操纵排名而大规模生产页面;另一条是 MC Created with Little Effort(4.6.6),针对几乎没有投入努力就生成出来的内容。2025 年之后,这类评估升级成了整站信号——判定不再是"这几页不行",而是"你这个站不行",一个版块拖累全站。
这不是"别做 Generator"的意思,是"别做那种用户拿走结果后发现跟别家一模一样的 Generator"的意思。判定标准值得直接读原文,Google Search Central 里有完整说明。
还能做的那批,产物都有一把尺子
我看下来还活得不错的 Generator,有个共同点:产物存在外部可验证的标准。生成的密码能不能过强度检测、生成的配色对比度是否达标、生成的 JSON 能不能被解析、生成的正则能不能匹配目标字符串。
有标准,质量就可以被判定,用户就分得出好坏,你的站才有差异化空间。
没有标准的那批——生成一句文案、生成一个名字、生成一段祝福语——好坏全凭主观,用户分不出来,也不会因为你多给了一个选项就记住你。Max Schmitt 做 Cakedesk 时一年收到 44 个功能请求只完成 13 个,用户照样在买,因为发票这个功能有没有做对,是有客观标准的;生成器如果落到"多给你十种风格"这种方向上,加再多也没人因此留下。
问题不是 Generator 还能不能做,而是:你生成的那个东西,有没有一把尺子能量它?
Product Hunt 发布量与上首页比例为公开统计;Omni Calculator 访问量为 2026 年 6 月 Semrush 估算;Cakedesk 数据来自 Max Schmitt 公开更新;Google 政策编号引自官方垃圾内容政策文档。