
我拆了一个 PDF 工具网站,发现它真正的核心不是 PDF
TinyWow 现在有 250 多个免费工具,月访问量按第三方估算在 180 万到 230 万之间。但它的起点非常小——2019 年,一个 PDF 转换器。
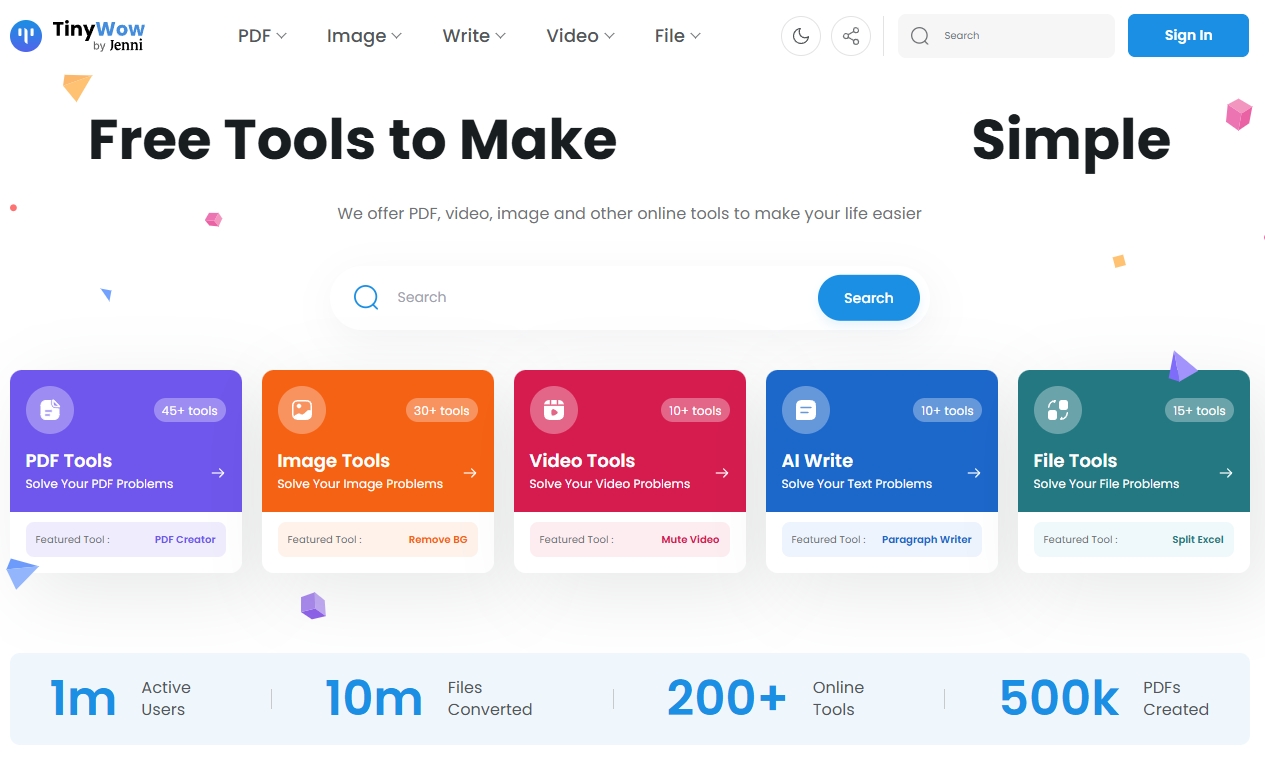
TinyWow 首页把工具收进 PDF、Image、Video、AI Write、File 五个入口,卡片上标的工具数量从 10+ 到 45+ 不等。
一个 PDF 转换器长成 250 个工具,中间发生了什么?这个问题我拆了挺久,最后得到的答案有点反直觉:它真正做的不是 PDF,是"文件格式处理"这个动作本身。
PDF 只是那个最好用的入口词
为什么从 PDF 起步?因为 PDF 相关的搜索量足够大、意图足够明确、而且用户一定是带着一个具体麻烦来的:要合并、要拆分、要压缩、要转成 Word、要签名、要解锁。
这些动作在搜索里是分开的词。“merge pdf”“split pdf”“pdf to word”“compress pdf”——每一个都是独立的查询,每一个都对应一个具体动作。
这意味着一个 PDF 站天然就能拆出几十个页面,而且每个页面都有真实搜索量支撑。相比之下,"好用的在线编辑器"这种词搜索量虽然大,但没法拆——你不知道用户想干什么。
PDF 品类的第二个好处是需求永不过时。文档格式这件事变化极慢,PDF 从 1993 年到现在还是 PDF。这跟那些依赖新技术热度的品类完全不同。
但把 250 个工具串起来的不是"PDF"
拆它的工具列表会发现,PDF 只占了一部分。图片、视频、文本、AI 写作,什么都有。
这些工具看起来毫无关联,但它们有一个共同点:都是"把一个文件变成另一个文件"。
用户心智里装的不是"我要用 PDF 工具",是"我手上这个文件不对劲,得处理一下"。TinyWow 抓住的是后者。PDF 只是当年最容易切入的那个场景,一旦用户在"处理文件"这件事上记住了你,你加图片工具他会用,加视频工具他也会用。
这解释了一个我以前想不通的现象:很多工具站的功能列表看起来乱七八糟,但流量就是好。因为功能之间不需要逻辑关联,只需要都落在同一个用户动作上。
反过来看那些做"专注"的产品——只做 PDF,做到极致。它们在单品体验上确实更强,但天花板也更明显:用户一年用三次 PDF 工具,用完就走,没有理由再回来。而一个覆盖 250 个动作的站,用户在不同场景下会反复想起它。
技术上的关键:每个工具都是独立的入口
这类站的技术实现有个很值得学的地方:每个工具是一个独立 URL、一个独立页面、一个独立搜索入口。
它不是做一个"文件处理应用",让用户进来选功能;而是做 250 个页面,每个页面针对一个具体查询。用户从搜索直接落到"PDF 转 Word"这个页面,不需要经过首页,不需要理解这个站是干什么的。
这对技术选型有直接影响。页面必须是静态的、可预渲染的、能被搜索引擎完整抓取的——也就是说,工具页面本身不能是前端路由渲染出来的空壳。用 JavaScript 做交互没问题,但页面的 HTML 骨架必须在服务端就生成好。
计算放在哪一端也要分开看。轻量的处理——图片压缩、文本转换、格式互转——全部放在浏览器里,用 WebAssembly 跑编解码器,服务器只发静态文件。重活——大文件、视频转码、批量处理——才走服务端队列。
这个划分决定了成本结构。TinyWow 敢承诺"文件 1 小时后自动删除",前提是它有能力把大部分处理留在不需要落盘的路径上。一个把所有文件都传到服务器处理的站,成本会是它的很多倍。
拆完之后,我会抄什么
第一条:从一个意图明确、可以拆成几十个页面的品类切入。 PDF 是这个思路,图片格式转换也是。判断标准是——这个品类的搜索词能不能自然拆成"动词 + 对象"的组合。能拆的,就适合做页面矩阵;只能整体描述的,不适合。
第二条:别被品类名限制住。 做 PDF 不代表只做 PDF。真正要抓住的是用户那一刻的动作,而不是文件后缀。
第三条:把工具做成入口,不要做成应用。 用户从搜索来,就该直接落在能用的页面上。让它先进首页再找功能,等于在漏斗中间加了一道门。
想清楚了这三条,再去看那些在线工具集合站为什么能做成,逻辑就很清楚了:它们卖的不是某个功能有多强,是"不管你手上这个文件出了什么问题,这里大概都有个东西能处理"。
TinyWow 工具数量与其发展过程引自其官网 About 页面;流量为第三方估算工具 2026 年上半年数据。