
一个新网站上线后,Google多久开始收录?
一个刚做完 DNS 解析、外链为零的新站,Google 摸到它的路径只有三条:sitemap 提交、别人页面上的链接指向你、以及少量真实用户行为数据。第一条你能完全控制,后两条控制不了。所以时间范围要分开说。
提交过 sitemap、并且 Search Console 验证完成的站,首批页面通常 3 到 14 天进入索引,快的隔天就能在「网页」报告里看到几十条。什么都没提交的站,可能 4 到 8 周才开始稳定收录——不是 Google 慢,是它得先找到入口、摸清你有多少页面、判断这些页面值不值得反复来。
这个区间是经验值,Google 官方从不承诺时限。Google Search Central 关于抓取与索引的文档反复强调的一点就是:sitemap 是提示,不是收录保证。
判断进展要看三类状态的迁移,不是 site: 语法
很多人每天敲一遍 site:example.com 数结果,这个数字既滞后又不准。该看的是 Search Console「网页」报告里的状态分布:
已发现 – 尚未抓取:Google 已经知道这个 URL,还没排上队。这个数长期不降,说明抓取预算吃紧,或者页面埋得太深。
已抓取 – 目前未编入索引:最该盯的一类。爬虫来过、读过、决定不收。原因通常落在三处——正文过短、与站内其他页面几乎重复、服务端返回的 HTML 是空壳。
已编入索引:到这一步才叫收录,之后才谈得上展示和点击。
单个 URL 想看细节,用顶部的 URL 检查工具,它会直接给出「上次抓取时间」和具体的拒绝原因,比任何猜测都准。验证站点、提交 sitemap 的完整流程在 Search Console 配置那一节。
空壳 HTML 是「已抓取但未编入索引」里最常见的原因
页面用前端路由渲染,爬虫拿到的只是一个 <div id="root"></div>,正文要等 JS 跑完才出现——在爬虫眼里这个页面就是空的。
用 JavaScript 做交互完全没问题,问题出在把首屏内容也交给了客户端。判据很朴素:在浏览器里禁用 JS,正文还在不在。不在,就还没到上线的时候。
三个会把首批收录拖到两个月以上的因素
域名有历史。 买来的老域名如果之前做过垃圾站、被投过 spam 外链,Google 需要更长时间重新建立信任。用 web.archive.org 查一下这个域名过去几年的快照,是上线前成本最低的一次体检。
robots.txt 写错了。 最常见的两种:上线时为了"先藏着"写了 Disallow: /,上线后忘了删;或者只 Allow 了首页。这类错误在「网页」报告里表现为一堆"已抓取 – 被 robots.txt 屏蔽",而且很多人根本不会去点开那个分类看。
页面只能靠交互加载。 无限滚动、需要点击"加载更多"才出现的列表、藏在 tab 里的分类页——这些页面在 HTML 里没有静态链接,爬虫走到列表底部就停了,后面的页面永远进不了"已发现"。
这三条都属于一次性问题,花半小时查完,能省掉一个月的等待。
上线当天就该做完的三件事
第一,robots.txt 里写一行 Sitemap: https://example.com/sitemap.xml,必须是绝对地址,同时在 Search Console 里提交一次。
第二,首页不要成为唯一入口,分类页要保证两跳内能到达所有内容页。首页挂几十个链接、剩下的页面只能靠搜索框找到,这种结构在新站阶段最伤。
第三,每个页面至少有一个来自站内的静态 <a href>,别只存在于 JS 生成的列表里。爬虫不执行你的交互逻辑,只顺着 HTML 里的链接走。
收录只是起步,离有流量还隔着一年
把收录当成终点会严重误判进度。Indie Hackers 上有人记录了 terrific.tools 的完整时间线:老老实实做了 12 个月,到 2025 年 11 月才迎来第一个完整变现月——展示广告 174.41 美元加卖桌面版的 125 美元,合计不到 300 美元,同期 3.4 万次会话、4.1 万次浏览。
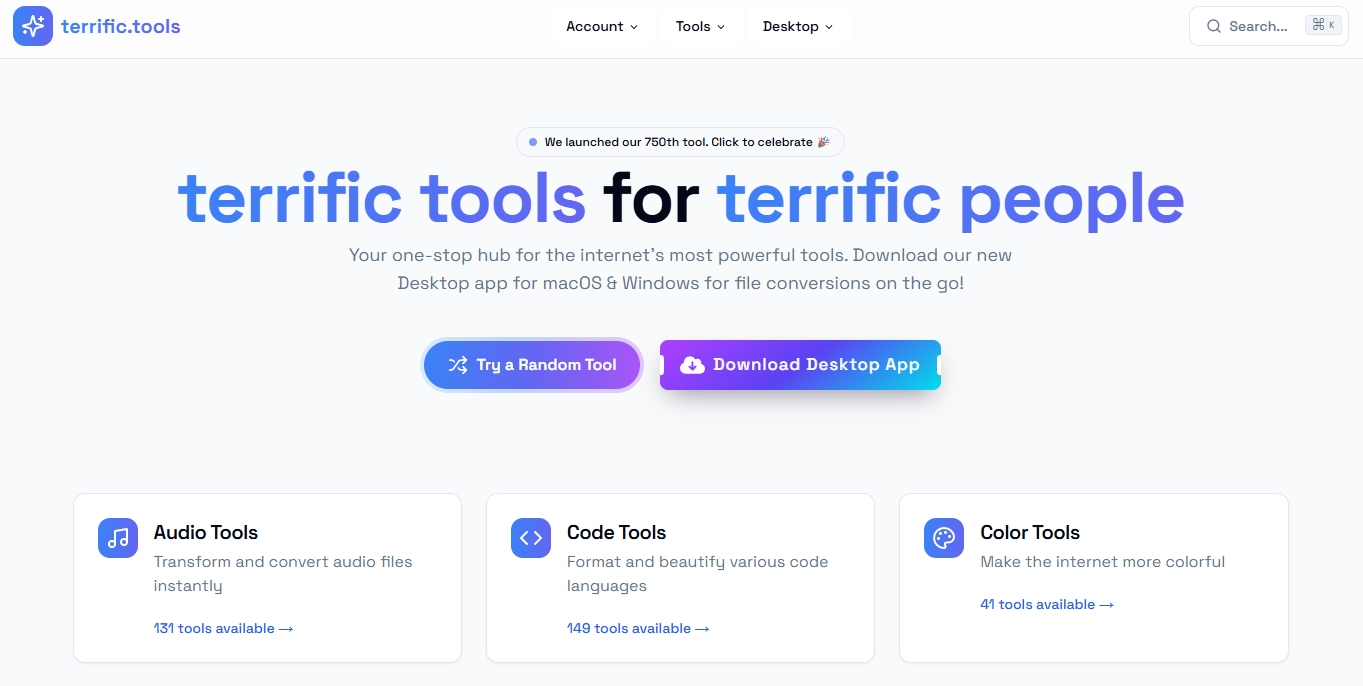
terrific.tools 首页在显著位置推 macOS 和 Windows 桌面应用,文件转换可以离线跑。
收录早就完成了,等的是排名爬升和外链积累。每天盯着索引数看,是新手最容易陷入的一种自我安慰。
terrific.tools 数据来自作者 2025 年 12 月在 Indie Hackers 的自述更新。